LLM이 만능이 아닐 때: 임베딩 + 로지스틱 회귀로 이미지 분류 자동화하기
들어가며
ArtPrep은 미대 입시 그림 모음 사이트입니다. 학원 블로그를 크롤링해서 합격작 이미지를 수집하고, 메타데이터와 함께 카드 형태로 홈화면에 보여주는 서비스죠.
문제는 블로그 글 하나에 합격작만 있는 게 아니라는 것이었습니다. 합격증 사진, 학생 사진, 학원 카드뉴스, 포스터. 이런 이미지들이 합격작과 뒤섞여 홈화면을 너저분하게 만들고 있었습니다.
목표는 단순했습니다. 이미지가 그림인지 아닌지 자동으로 판별하고, 프레임이 있으면 그림 영역만 크롭해주는 에이전트를 만드는 것.
하지만 그 과정은 단순하지 않았습니다.
첫 번째 시도: LLM에게 맡겨보자
가장 먼저 떠오른 방법은 Claude Haiku 4.5에게 판별을 맡기는 것이었습니다. 블로그 글 하나를 통째로 주고, 그 안에서 그림을 골라달라고 요청했죠.
결과는 참담했습니다....!
Haiku가 "그림"이라고 판정한 342장을 직접 확인해보니:
- ✅ 실제 그림: 170장 (50%)
- ❌ 그림 아님: 148장 (43%)
- ❓ 모름: 24장 (7%)
모름을 제외하면 46.5%가 오답이었습니다. 이 정도면 그냥 전부 올리는 것과 크게 다를 바 없습니다.
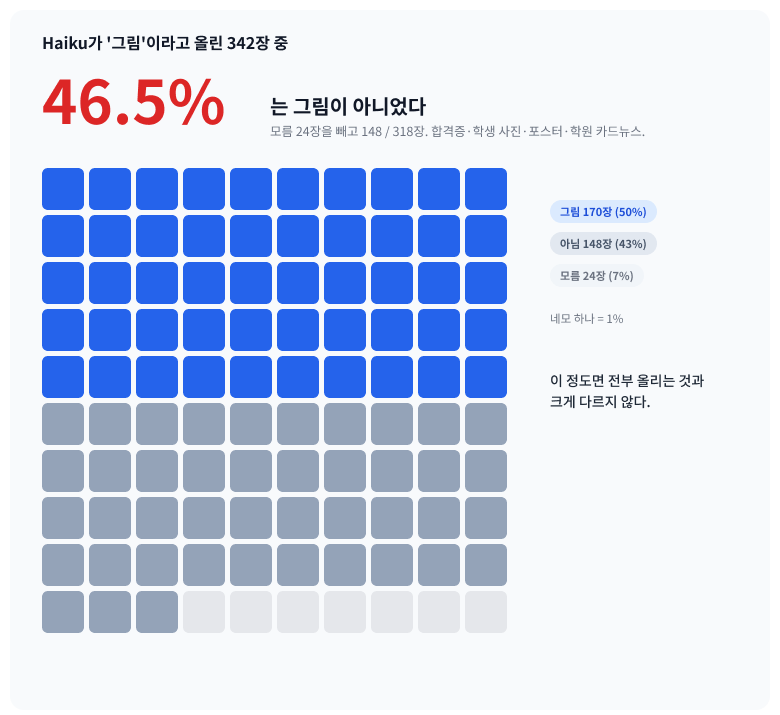
Haiku가 그림이라고 올린 342장을 팀 라벨과 대조했다. 46.5%는 그림이 아니었다.
폐기한 방법들
프롬프트 개선: 측정할 수 없는 개선은 개선이 아니다
"프롬프트를 더 잘 쓰면 되지 않을까?" 당연히 시도해봤습니다. 하지만 근본적인 문제가 있었습니다.
AI의 비결정성 때문에 같은 프롬프트로 같은 사진을 두 번 물어봐도 답이 달라질 수 있습니다. 문장을 고친 뒤 정확도가 2% 올랐을 때, 그게 프롬프트 덕분인지 단순한 우연인지 구별할 방법이 없었습니다.
개선 여부 자체를 검증할 수단이 없다면, 그건 엔지니어링이 아닙니다. 그래서 쿨하게 폐기했습니다.
파인튜닝: 500장으로는 부족하다
파인튜닝도 검토했지만, 라벨 데이터가 500장뿐이었습니다.
- 모델 가중치 수천만 개를 500장으로 다시 맞추면 → 과적합 (그 500장은 외우고 새 사진은 틀림)
- 원래 수억 장으로 배운 지식도 깨짐 → catastrophic forgetting (Kumar 외 2022, Wortsman 외 2022)
- 컴퓨팅 리소스 부담까지
수억 장으로 "사진이 무엇인지" 이미 학습한 모델을, 고작 500장으로 재학습시켜서 기존 지식을 망각시키는 건 직관적으로 맞지 않았습니다.
최종 선택: SigLIP2 임베딩 + 로지스틱 회귀
발상을 전환했습니다. 모델을 바꾸는 대신, 모델이 이미 아는 것을 활용하자.
SigLIP2: 사진을 숫자로 바꾸는 번역기
SigLIP2는 Google이 공개한 비전 모델입니다. 수억 장의 이미지로 학습되어 "사진이 무엇인지"를 이미 알고 있죠.
이 모델에 사진 1장을 넣으면 숫자 768개가 나옵니다. 이 숫자들은 사진의 생김새를 요약한 좌표값으로, 비슷한 사진은 비슷한 숫자가 됩니다.
핵심은 SigLIP2의 가중치는 건드리지 않는다는 것입니다. 수억 장으로 배운 지식을 그대로 활용합니다.
로지스틱 회귀: 768개 숫자로 그림/아님 판별
SigLIP2가 뽑아준 숫자 768개에 각각 가중치를 곱해서 모두 더합니다. 합이 크면 그림, 작으면 아님으로요. 이 합계를 시그모이드 함수로 0~1 사이 확률로 변환합니다.
우리가 학습시키는 건 가중치 768개뿐. 수천만 개가 아니라 768개이기 때문에, 500장으로도 과적합 없이 충분히 학습할 수 있을 것이라 기대했습니다.
학습 과정
- 총 550장 라벨링 (그림 206장, 아님 305장, 모름 39장 제외 → 유효 511장)
- 홀드아웃 60장을 별도 보관, 나머지 451장으로 학습
- 5겹 교차검증 정확도: 0.929
- 학습 시간: 노트북 CPU로 임베딩 추출 3분, 회귀 학습 1초
결과: 모든 지표에서 압도적 개선
홀드아웃 60장 기준 성능 비교:
지표Haiku그림 선별기 (threshold 0.5)개선 폭정확도0.6670.917+25.0%p정밀도0.5590.828+26.9%p재현율0.7921.000+20.8%pF10.6550.906+25.1%p
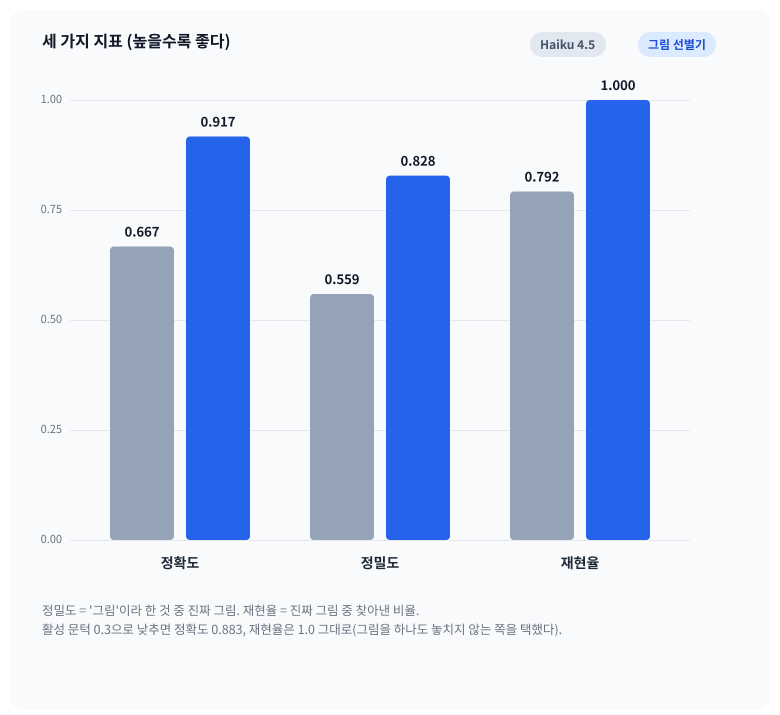
학습에 쓰지 않은 60장으로 비교했다. 정확도 0.667에서 0.917.
특히 재현율 100%. 실제 그림 24장을 단 하나도 놓치지 않았습니다. Haiku는 그림이 아닌 36장 중 15장을 오판했지만, 그림 선별기는 5장만 오판했습니다.
Threshold 0.3: 놓치지 않는 쪽을 택하다
운영 기준은 0.5가 아닌 0.3으로 설정했습니다. 홈에 비그림이 조금 섞이는 것보다, 진짜 그림을 놓치는 것이 사용자 경험에 더 치명적이라고 판단했기 때문입니다. 0.3에서도 재현율 1.0을 유지합니다.
비용: Haiku의 1/14
모델1,000장당 비용Sonnet 4.6₩4,629Haiku 4.5₩1,543그림 선별기₩114
Haiku 대비 약 1/14, Sonnet 대비 약 1/41 수준입니다. 더 정확하면서 더 저렴합니다.
테두리 크롭: OpenCV 3단계
그림을 판별한 뒤, 학원 카드뉴스 형태의 이미지에서 실제 그림 영역만 찾아 크롭하는 기능도 구현했습니다.
단계내용세부 사항① 블록마다 색 수를 센다16px 블록 분석사진 블록은 중위 24색, 배경·글자는 6색② 긴 직선을 찾는다Canny 가장자리 → Hough 직선87px 넘는 직선만 추출③ 네모 후보에 점수를 매긴다직선 쌍으로 네모 구성변 덮임 + 안팎 색 차이 + 안쪽 질감으로 점수 산출
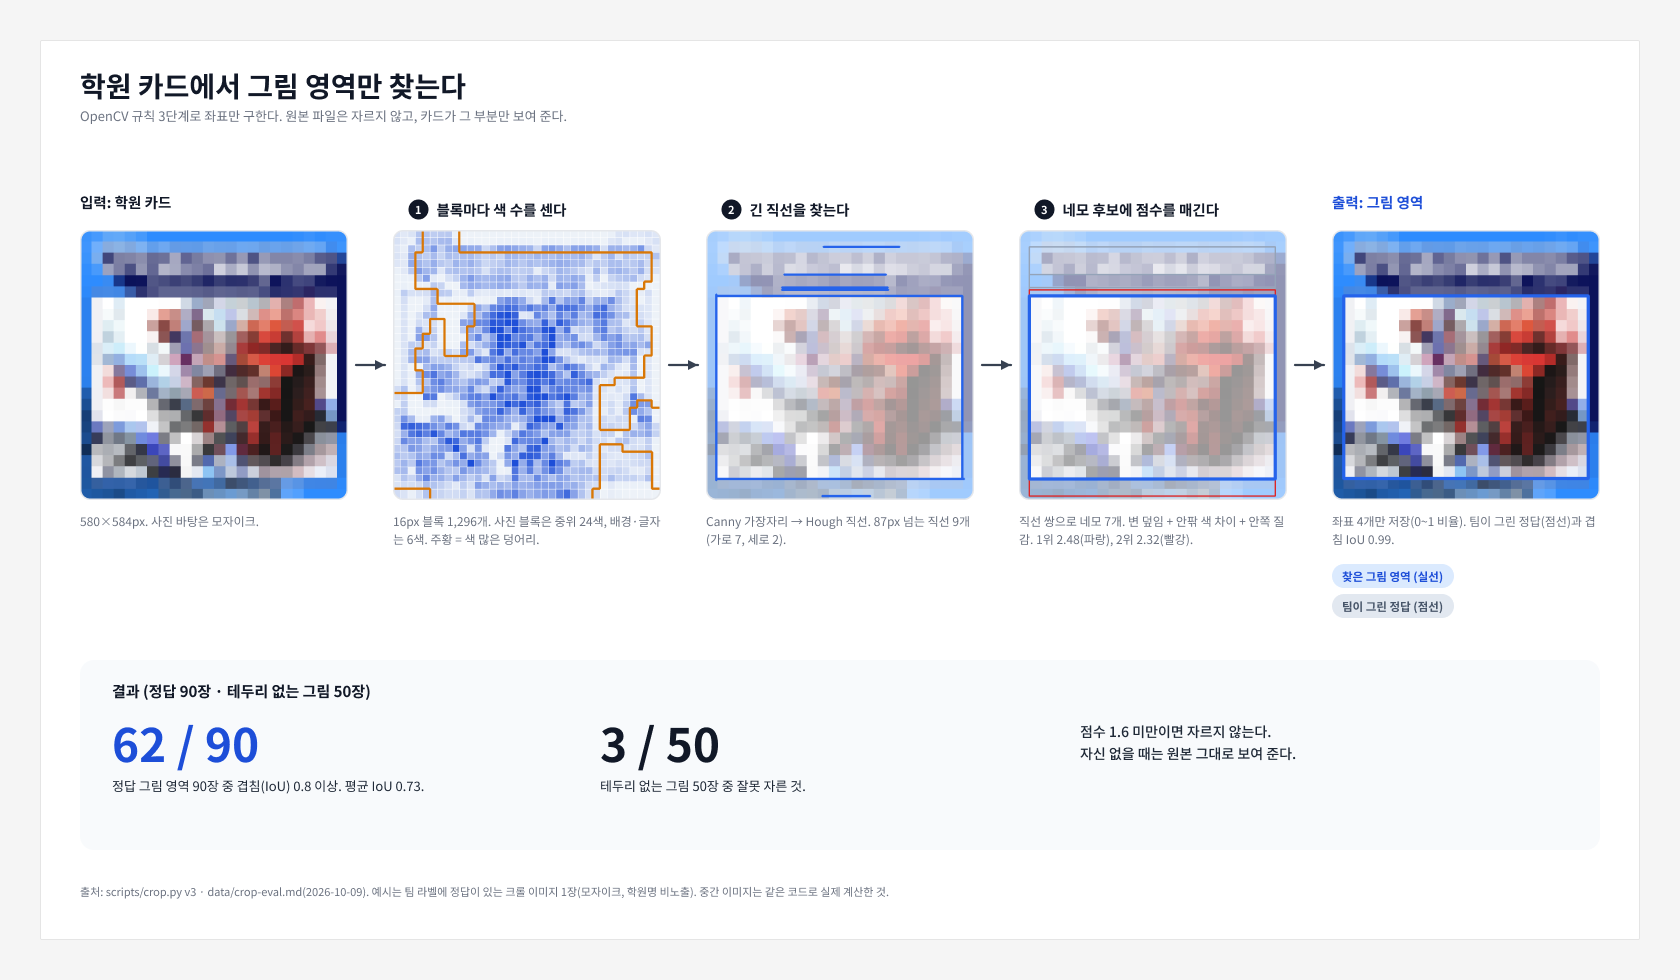
학원 카드에서 그림 영역만 찾는다. 블록 색 수 → 긴 직선 → 후보 점수. 중간 이미지는 같은 코드로 실제 계산한 것.
점수 1.6 미만이면 자르지 않고 원본 그대로 보여줍니다. 자신 없을 때는 건드리지 않는 것이 원칙입니다.
크롭 성능: 정답 90장 중 62장이 IoU 0.8 이상 (68.9%), 평균 IoU 0.732.
전체 파이프라인
블로그 글 → 이미지 추출 (Edge Function)
→ Haiku 태깅 (대학·실기유형·종류)
→ 그림 선별기 (SigLIP2 + 로지스틱 회귀) [SageMaker 서버리스]
→ 테두리 크롭 (OpenCV)
→ 저장 + threshold 0.3 적용
→ 홈 카드 노출
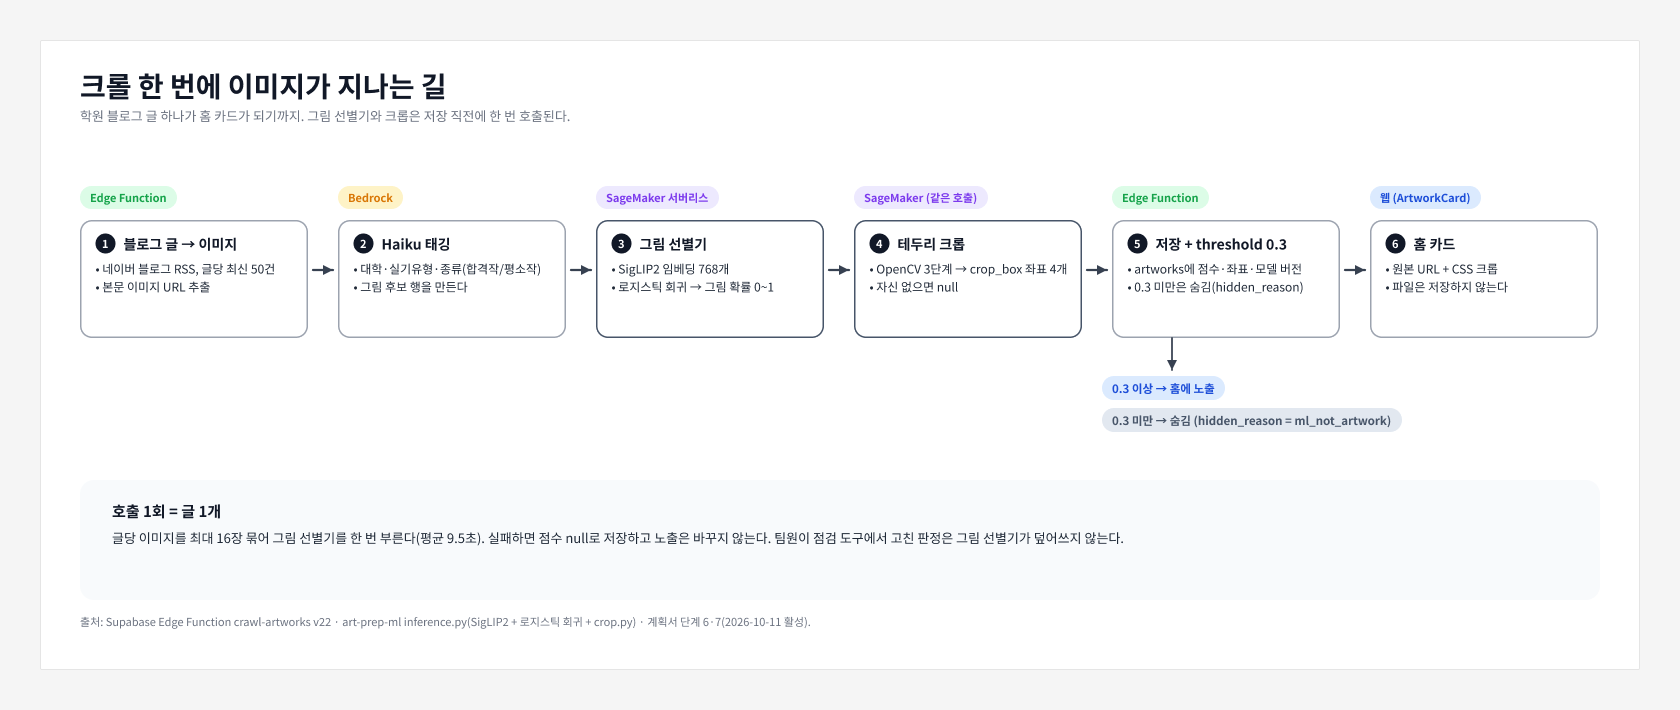
크롤 한 번에 이미지가 지나는 길. 그림 선별기와 크롭은 저장 직전에 한 번 호출된다.
글 1개당 이미지를 최대 16장 묶어 그림 선별기를 한 번 호출합니다 (평균 9.5초). 실패하면 점수 null로 저장하고 기존 노출 상태를 유지합니다. 팀원이 수동으로 고친 판정은 덮어쓰지 않습니다.
실전 적용 결과
기존 데이터 재채점
- 총 1,278행 재채점
- 기존 노출 387행 중 77행이 숨김 처리 (0.3 미만)
- 410개 행에 대해 크롭 재진행
- 실제 청구 금액: ₩0 (SageMaker 서버리스 무료 구간)
1주차 점검 (10/16)
- 새 크롤 13장 중 5장이 0.3 미만으로 숨겨졌습니다 (점수 0.08~0.29)
- 그런데 이 5장은 전부 만화·애니 합격작이었습니다. 라벨에 만화·애니가 적어 생긴 edge case로, 라벨을 보강해 재학습할 예정입니다
- 통과한 8장: 점수 0.38~0.89
- 채점 누락·오류: 0건
Lessons Learned
✅ Wins
- 풀스택 ML 경험: 문제 정의 → 방법 선정 → 시스템 설계 → 모델 평가 → 테스트 → 배포까지 전체 사이클을 직접 경험했습니다. 한 번 해보고 나니까 이해도가 훨씬 높아진 게 체감되더라고요. 이번 프로젝트 경험을 바탕으로 ML 엔지니어 Certification 공부해보려 합니다.
- 실질적 품질 향상: 홈화면에서 불필요한 이미지가 사라지고, 콘텐츠 퀄리티가 눈에 띄게 좋아졌습니다.
❌ Misses
- MECE하지 못한 의사결정: Claude가 추천해주는 3가지 방법 안에서만 의사결정을 했습니다. AI의 가드레일 안에서만 생각하게 되는 한계를 느꼈고, 다음에는 직접 더 넓게 탐색해보고자 합니다.
예산 초과
항목계획실제초과 이유개발 시간8시간10시간라벨 도구·점검 모드·엔드포인트 재배포라벨링 인건비₩6,880₩14,790팀 라벨 550장 보강 + 사이트 점검 113건
Next Step
- Start: 재학습 자동화 구축, 만화·애니·조소 등 edge case 라벨 보강
- Stop: Haiku 판별 결과를 노출 기준에서 제거 → ML 점수만 사용 (1,000장당 ₩1,543 절감 가능)
- Continue: 웹 노출 이미지 모니터링, "라벨 → 임베딩 + 회귀 → shadow mode → live" 골격 유지
마치며
LLM이 만능처럼 느껴지는 시대입니다. 하지만
LLM이 답이 아닐 때, 클래식 ML이 더 정확하고, 더 저렴하고, 더 예측 가능한 답이 될 수 있습니다.